

نظام “Play2Perfect” يسجل قفزة تعادل 33 ضعفاً في كفاءة تدريب الروبوتات على التجميع
أفادت دراسة تمهيدية منشورة عبر منصة “arXiv” بنجاح نقل النموذج بالكامل من بيئة المحاكاة إلى روبوتات حقيقية دون تدريب إضافي، بما في ذلك تحقيق معدل نجاح بلغ 60%…
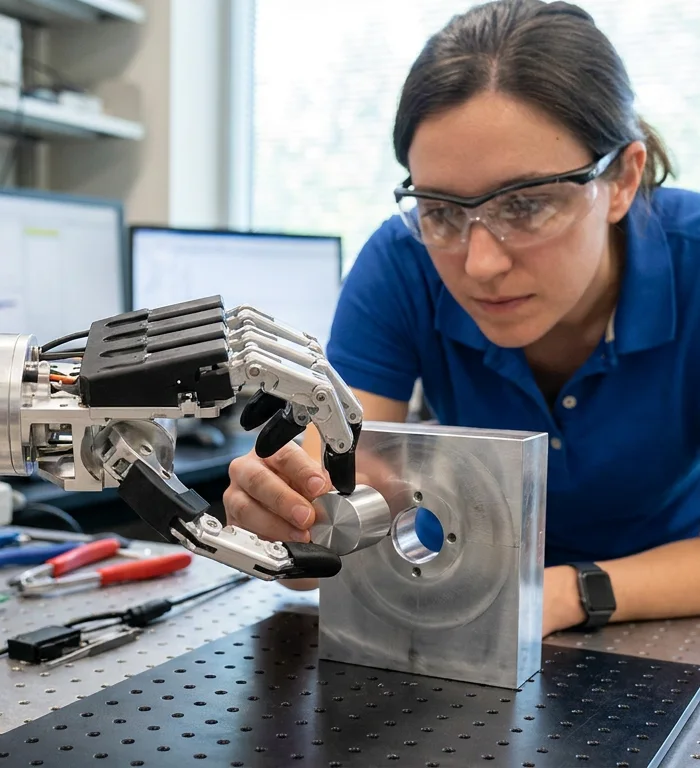
حقق "Play2Perfect"، وهو إطار عمل للتعلم المعزز في مجال الروبوتات، زيادة في كفاءة العينات تعادل 33 ضعفاً مقارنة بالتدريب من نقطة الصفر، وذلك وفقاً لدراسة تمهيدية نُشرت عبر منصة "arXiv" في 17 أكتوبر من قِبل تايلر غا وي لوم وثلاثة مؤلفين مشاركين.
وتعد هذه المقارنة بمقدار 33 ضعفاً محور الرهان الرئيسي في الدراسة المنشورة في 17 أكتوبر، والتي تستهدف عمليات التجميع الدقيقة، حيث يشير المؤلفون إلى أن الروبوتات متعددة الأصابع لا تزال تواجه صعوبات فيها على الرغم من استخدام مقابض متخصصة وملحقات للأدوات ومثبتات ميكانيكية.
ويمكن أن يكون التعلم المعزز، وهو أسلوب يطور فيه البرنامج تصرفاته عبر إشارات المكافأة، باهظ التكلفة في مهام التجميع لأن التغذية الراجعة المفيدة قد لا تتحقق إلا بعد حدوث تلامس مادي معقد. ويصيغ المؤلفون بديلهم بوضوح: "قبل أن يتمكن الروبوت من إتقان التجميع الدقيق، يجب عليه أولاً أن يتعلم اللعب".
ويدرب إطار "Play2Perfect" الروبوت تدريباً مسبقاً من خلال اللعب غير المرتبط بمهمة محددة عبر أجسام وأهداف متنوعة، ثم يُجري ضبطاً دقيقاً لتلك الخبرة السابقة لتطبيقها في التجميع. ويقول المؤلفون إن مرحلة اللعب تبني مهارات تحكم قابلة لإعادة الاستخدام، بما يشمل الإمساك بالأشياء، وإعادة توجيهها داخل اليد، والوصول إلى الوضعيات المستهدفة.
وجاءت المكاسب المسجلة بالمقارنة مع التعلم المعزز من نقطة الصفر، حتى في الحالات التي تلقى فيها النموذج الأساسي مكافآت مكثفة ومتعددة المراحل، وفقاً للدراسة التمهيدية. وتوفر المكافآت المكثفة إشارات أكثر تواتراً خلال التدريب مقارنة بالمكافآت الشحيحة، التي غالباً ما تقدم تغذية راجعة فقط عند تحقيق الهدف النهائي.
كما أفاد المؤلفون بنجاح النقل المباشر من المحاكاة إلى الواقع دون تدريب إضافي، ما يعني تطبيق السياسة المدربة في بيئة المحاكاة على عتاد مادي دون الحاجة إلى تدريب إضافي في العالم الحقيقي ضمن الإعداد المذكور. وفي تلك الاختبارات، حقق النظام نسبة نجاح بلغت 60% في مهام الإدخال المحكم للأجزاء التي بلغ هامش خلوص التلامس فيها 0.5 مليمتر، وهو ما يعادل تقريباً سُمك سن قلم رصاص ميكانيكي تقليدي.
وبالنسبة للمهام الأطول، سجل المؤلفون معدلات نجاح تجاوزت 50% في عمليات تجميع الأجزاء المتعددة وربط البراغي. وتشير الورقة البحثية أيضاً إلى دراسة خيارات التصميم في التدريب المسبق، بما في ذلك تنوع الأجسام، وتصميم الأهداف، وتنوع المسارات، ودقة الهدف.
وتظل هذه النتائج بحثاً أولياً وليست تطبيقاً تجارياً.
وقُدمت الورقة البحثية لأول مرة في 24 يونيو، ونُقحت نسختها الرابعة في 15 أكتوبر. وتتضمن صفحة الورقة على منصة "arXiv" ما مجموعه 26 صفحة و19 شكلاً توضيحياً وأربعة جداول مدرجة ضمن قسمي الروبوتات والذكاء الاصطناعي.
المصدر: دراسة تمهيدية عبر منصة "arXiv"، تصنيف cs.RO/cs.AI، نُشرت في 17 أكتوبر 2026؛ النُسخة الرابعة المنقحة في 15 أكتوبر 2026.
More stories
- ديب سيك تحدث نموذجها للذكاء الاصطناعي مع احتدام المنافسة على السرعة والتكلفة
- عوائد سندات "كور ويف" تلامس 15% وسط تفاقم الشكوك بشأن تمويل الذكاء الاصطناعي
- أسبوع الألعاب: رؤوس الأموال الانتقائية تصطدم بمعايير أداء أكثر صرامة
- لعبة "بهاغ نيها بهاغ" تجتذب 2700 لاعب وسط موجة ألعاب إلكترونية مستوحاة من احتجاجات حزب المواطنين من أجل العدالة في الهند
- كوتوخ يحدد تفوق القنوات الجانبية الكمومية عند رتبة 2^58.6 لتشفير AES-128
- تقارير الأزمات الصادرة عن نماذج اللغة الكبيرة تلتقط ما بين 5.4% و11.0% فقط من الأرقام الرسمية
- أنثروبيك تطلق نموذج Claude Opus 5 بتكلفة مخفضة للشركات
- سياسات ميتا الجديدة تقيد تسجيل الفيديوهات السرية عبر نظاراتها
آخر الأخبار
- الشرطة الفرنسية تعتقل أكثر من 1,800 شخص عقب احتجاجات على غلاء المعيشة
- سكر Neu5Gc في اللحوم يرتبط بارتفاع خطر السكري بنسبة 63%
- غودونغوانا يواجه اختبار دين بنسبة 80% في تحديث الميزانية
- جورجيا تواجه تدقيقاً بشأن تأجير الأرحام بعد تسجيل 1100 ولادة في عام 2023
- مهرجان الجونة يختار 5 صناع أفلام للدفعة الثالثة من برنامج "نجوم صاعدون"
- مركب الفانيلين يُظهر إمكانات في علاج الجروح وفق أبحاث أولية
- استعادة بروتين مينين تحسن ذاكرة الفئران المسنة خلال 30 يوما
- فيخو يستهدف مقاعد كتالونيا الـ48 بتعهد إسكاني يقوده ألبيول