LLM önyargı ölçümü: Token olasılıklarıyla Likert dağılımı
LLM önyargı ölçümü için arXiv ön baskısı, token olasılıklarına dayalı Likert dağılımı ve tam faktöriyel test tasarımı öneriyor.
Cuneyd Erdogan ·
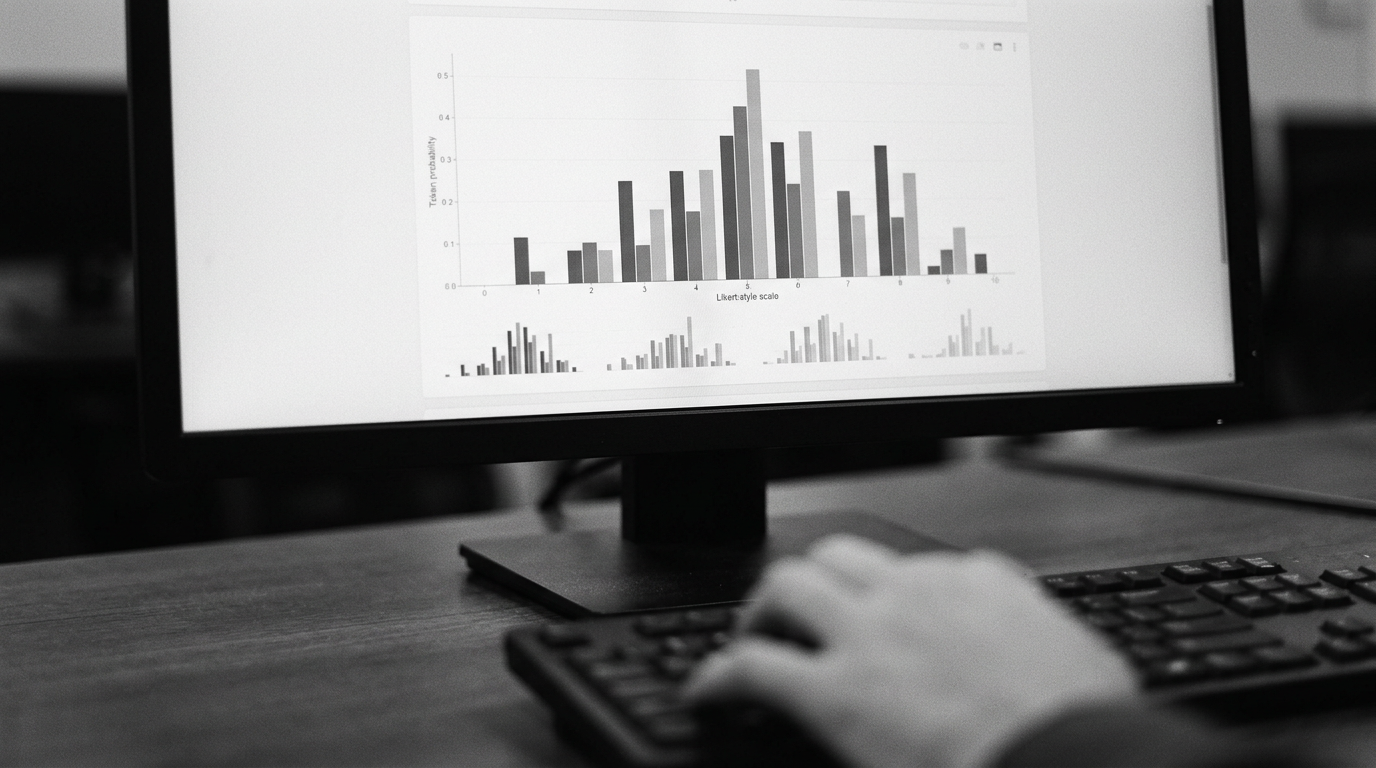
Yeni bir arXiv ön baskısı, büyük dil modellerinde (LLM) tutum ve önyargı ölçümünü serbest biçimli prompt’lara dayanan pratiklerden daha yapılandırılmış bir psikometrik çerçeveye taşımayı öneriyor. Çalışma, kurumların sık kullandığı “örnek çıktı okuyup yorumlama” yaklaşımının karşılaştırılabilirlik ve ölçüm hatası ürettiği varsayımından hareket ediyor. Metin, akademik ön baskı niteliği taşıyor ve bulguların bağımsız tekrarlarla doğrulanması ile farklı bağlamlarda uygulanabilirliğinin test edilmesi henüz net değil.
Önerilen yöntemin merkezinde, modelin yalnızca nihai yanıtı değil, yanıtı üretirken seçtiği her bir token için oluşturduğu olasılık kütle fonksiyonları (PMF) yer alıyor. Bu çerçevede ölçüm nesnesi, “model şunu söyledi” sonucundan çok, olası yanıtların olasılık dağılımı oluyor. Çalışma, Likert ölçeği gibi dereceli yanıtların tek bir işaretleme gibi ele alınması yerine, yanıt seçeneklerinin tam dağılımının çıkarılmasının tutum ve önyargı ölçümünde daha sağlam bir temel sağlayabileceğini savunuyor.
Serbest prompt yerine tam faktöriyel test tasarımı Ön Serbest prompt yerine tam faktöriyel test tasarımı Ön baskı Ön baskı, LLM değerlendirmelerinde serbest prompt kullanımının sonuçları rastlantısallığa açık hale getirdiğini ve farklı model sürümleri ya da sağlayıcılar arasında kıyas yapmayı zorlaştırdığını öne sürüyor. Bunun yerine yazarlar, “tam faktöriyel” (fully crossed factorial) deney tasarımını öneriyor; yani testteki koşulların sistematik biçimde çaprazlandığı, aynı testin yeniden üretilebildiği bir düzen. Bu yaklaşım, ölçümün tekrar edilebilirliğini artırma iddiası taşıyor ve denetim izleri açısından daha belirgin bir çerçeve sunmayı hedefliyor. Kurumlar açısından tartışma, etik bir başlıktan çok model risk yönetimi ve uyum süreçlerinde “testin yeniden çalıştırılabilirliği” etrafında şekilleniyor. Müşteri iletişimi, çağrı merkezi asistanları, satış destek botları ve insan kaynaklarında ön eleme gibi alanlarda önyargı riski operasyonel maliyete ve itibar riskine dönüşebiliyor. Bu nedenle, ölçümün daha nicel tanımlanması ve standardize raporlamaya bağlanması tedarikçi yönetimi ve iç kontrol pratiklerini etkileyebilir. Standardizasyon ve denetlenebilirlik baskısı Çalışma, token düzeyi olasılıklara dayanan dağılımsal metriklerin, LLM “eval” araçları ve danışmanlık hizmetlerinde metodoloji rekabetini öne çıkarabileceğini işaret ediyor. Eğer kurumlar bu tür metrikleri sözleşmesel gereklilik haline getirirse, rapor formatı, metrik tanımı ve test kapsamı daha net tanımlanabilir. Bu da model seçimi ve sürüm geçişlerinde “aynı testle kıyas” beklentisini güçlendirebilir. Reel GSY Buna karşın metin, yöntemin sahadaki maliyeti ve uygulama karmaşıklığı konusunda somut uygulama verisi sunmuyor. Ayrıca, daha karmaşık ölçüm çerçevelerinin otomatik olarak daha iyi yönetişim anlamına gelmediği vurgulanıyor; eşiklerin nasıl belirleneceği, yanlış pozitif/negatif sonuçların maliyetinin nasıl yönetileceği ayrı bir yönetişim alanı oluşturuyor. Bir diğer pratik sınır da kapalı modellerde token olasılıklarına erişimin sınırlı olabilmesi; sağlayıcı şeffaflığı, yöntemin uygulanabilirliğini doğrudan belirleyebilir.
Ön baskı, kısa vadede izlenebilecek sinyalleri de tarif ediyor: Token olasılıklarını ölçüm amaçlı açan sağlayıcıların artıp artmadığı, eval araçlarının Likert dağılımı gibi dağılımsal metrikleri standart raporlamaya alıp almadığı ve üçüncü taraf denetim çerçevelerinin tam faktöriyel tasarımları referans gösterip göstermediği. Çalışmanın ana iddiası, kurumsal değerinin tek bir modelin “daha az önyargılı” olduğuna dair bir etiket üretmekten çok, aynı testin zaman içinde, sürümler arasında ve farklı sağlayıcılarda karşılaştırılabilir şekilde çalıştırılmasına bağlı olduğu yönünde.