

طريقة جديدة لتدريب الروبوتات ترفع نسبة النجاح في الاختبار المرجعي إلى 74.8%
تستهدف الدراسة الأولية مشكلة النسيان الكارثي، والتي تمثل عقبة أمام إكساب الروبوتات مهارات جديدة دون فقدان المهارات السابقة.
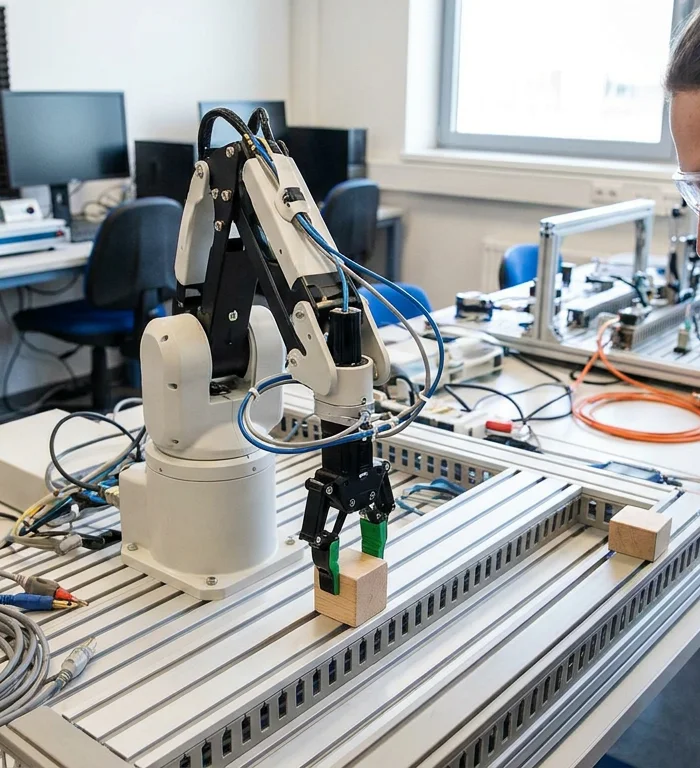
أفاد بهي ثروت وخمسة مؤلفين مشاركين، في مسودة بحثية نُشرت يوم الجمعة 9 أكتوبر على موقع "أركايف" (arXiv)، بأن طريقة "دريم تو ريممبر" (Dream to Remember) رفعت متوسط نسبة النجاح في اختبار "كالڤين" (CALVIN) المرجعي لتعلم الروبوتات إلى 74.8% مقارنة بنسبة 63.7%.
وتكتسب المسودة البحثية المنشورة في 9 أكتوبر أهمية خاصة لأنظمة تعلم الروبوتات التي يتعين عليها اكتساب مهارات إضافية بمرور الوقت. وقال المؤلفون إن ضبط نموذج "لورا" (LoRA)، أو التكيف منخفض الرتبة لأوزان النماذج، تراجع إلى 11.7% في تسلسل المهام الثماني نفسه.
وتستهدف طريقة "دريم تو ريممبر"، المعروفة اختصاراً بـ "D2R"، سياسات الروبوت العامة، وهي نماذج مصممة لأداء مهام روبوتية متعددة بدلاً من روتين أداء محدد وضيّق. وقال المؤلفون إن هذه السياسات تُدرّب عادة عبر التعلم بالمحاكاة، حيث يتعلم الروبوت من العروض التوضيحية، مما يجعل الأداء مرتبطاً بجودة هذه الأمثلة وشموليتها.
وتتمثل المشكلة المحورية في الورقة البحثية في "النسيان الكارثي"، وهو ميل نظام التعلم إلى فقدان القدرات السابقة بعد تدريبه على مهام لاحقة. وفي بيئات المهام المتسلسلة، قال المؤلفون إن الضبط الدقيق قد يضعف المهارات القديمة، في حين إن توجيه سياسة توليدية مجمدة قد ينقل مشكلة النسيان إلى وحدة التوجيه المشتركة.
وتعمل طريقة "D2R" على إبقاء السياسة العامة الأساسية مجمدة مع تدريب وحدة توجيه أصغر حجماً لتنفيذ المهام الجديدة. وأثناء ذلك التدريب، يقدم نموذج عالم مُدرّب مسبقاً ومجمد—وهو محاكي متعلَّم لكيفية تغير البيئة—سيناريوهات يتخيل فيها تنفيذ المهام السابقة لكي تظل وحدة التوجيه قريبة من سلوكها السابق.
وقال المؤلفون إن عملية المراجعة والتكرار هذه تعمل دون الحاجة إلى ذاكرة تخزين مؤقت لإعادة التشغيل، والتي من شأنها تخزين أمثلة التدريب القديمة، ودون جمع بيانات جديدة للمهام السابقة. وأضافوا أن طريقة "D2R" يمكنها تدريب مهارة جديدة بالكامل عبر التخيل عندما يكون نموذج العالم دقيقاً بدرجة كافية للمهمة الجاري تحسينها.
وعندما لا يكون نموذج العالم موثوقاً بدرجة كافية للتدريب المباشر، تستخدم الطريقة إعداداً مختلفاً. وقال المؤلفون إن طريقة "D2R" يمكنها تعلم المهمة الجديدة في البيئة الحقيقية أو بيئة الاختبار المرجعي مع الاستمرار في استخدام نموذج العالم لمراجعة المهام السابقة فقط.
وتضمنت الورقة البحثية اختبارات تجاوزت بيئة "CALVIN"، بما في ذلك اختبار "LIBERO-90" المرجعي لتعلم الروبوتات المذكور في المسودة. وباستخدام سياسة عامة مجمدة وجاهزة تُدعى "π0" ونموذج عالم يسمى "A2World"، قال المؤلفون إن "D2R" تعلمت مهام في بيئة "LIBERO-90" لم تكن مرئية لها من قبل.
وفي إعداد "LIBERO-90" هذا، قال المؤلفون إن طريقة "D2R" حافظت على أداء سياسة "π0" ضمن مجموعات "LIBERO" التي جرى ضبط "π0" عليها سابقاً. وذكروا أن هذا تحقق حتى وإن لم يكن نموذج "A2World" دقيقاً بدرجة كافية لتحسين السياسة بشكل مباشر.
كما تضمنت الورقة نتيجة تطبيقية على روبوت حقيقي باستخدام ذراع الروبوت "فرانكا" (Franka). وقال المؤلفون إن "D2R" حسّنت أداء ثلاث مهام بالتتابع من خلال التدريب المتخيل وحافظت على التحسينات السابقة.
ولا تزال الأدلة أولية؛ إذ إن المسودة البحثية المنشورة على موقع "أركايف"، والمصنفة ضمن مجال الروبوتات والمرتبطة أيضاً بالرؤية الحاسوبية والتعرف على الأنماط والتعلم الآلي، لم تخضع بعد لمراجعة الأقران. كما أن الملخص لا يقدم فترات ثقة، أو تكاليف الحوسبة، أو نتائج كل مهمة على حدة، أو خطوط أساس مقارنة على روبوتات حقيقية.
كما تتضح الحدود العملية لهذه الطريقة من خلال الطرح الذي قدمه المؤلفون أنفسهم؛ إذ تعتمد طريقة "D2R" على مدى جدوى نموذج العالم، وعندما لا يتمكن هذا النموذج من دعم تحسين السياسة، يظل النظام بحاجة إلى التفاعل مع البيئة لإنجاز المهمة الجديدة.
ووفقاً لسجل موقع "أركايف"، قُدمت المسودة البحثية برقم (arXiv:2610.13816v1) بواسطة ثروت، وإيمان نعمت اللهي، ومارفين أليس، وشينغ يوان تشانغ، وأكشاي إل تشاندرا، وأبهيناف فالادا.
المصدر: مسودة بحثية على موقع أركايف (arXiv)، 9 أكتوبر 2026
More stories
- طريقة SAFE-QE تخفض مصطلحات البحث غير المدعومة إلى 4.3 في الاختبارات
- قد يحسّن إطار عمل TabMF استرجاع مجموعات بيانات الذكاء الاصطناعي عبر ست مهام
- إكس بوكس تختبر شارة تتابع مرتبطة باللعب 3 مرات أسبوعياً
- طريقة جديدة لتدريب الروبوتات ترفع نسبة النجاح في الاختبار المرجعي إلى 74.8%
- دار «آي دي دبليو» تبدأ رحلة «سونيك» نحو العدد 100
- توملين المحلل في شبكة NBC يتجنب ذكر اسم هنري ويستشهد بمعدل تقدم يبلغ 4.2 ياردة
- توسع قدرات الطاقة الحرارية الجوفية المحسّنة وتوسيع نطاق السوق
- اختراق بيانات شركة "أسوس" يسلط الضوء على ثغرات إدماج برمجيات كخدمة مع الأطراف الخارجية
آخر الأخبار
- أعراض انقطاع الطمث تكشف فجوة في أدلة الطب الرياضي والتمارين
- ترمب يقول إن المحادثات مع إيران تتعثر بعد مقتل قادة في ضربات
- تعرض سفينتين لهجوم بطائرات مسيرة قبالة بلغاريا وغرق إحداهما
- صندوق النقد الدولي يتوقع وصول التضخم في تركيا لعام 2026 إلى 31.2%
- شركة "ماروين" تُبرم مذكرة تفاهم لاختبار حوسبة الذكاء الاصطناعي لمدة 18 شهراً مع "أومني إكس"
- صادرات الفاكهة التركية تعيد التجارة مع روسيا إلى إطار العقوبات الأمريكية
- بيبليسي تعلن نمو الإيرادات بنسبة 5% في الربع الثالث وتؤكد توقعاتها المالية