

تقنية نقل الرسائل ترفع نسبة نجاح النماذج الصغيرة في حل ألعاب السودوكو إلى 72 %
أشار ملخص جونفان تشو لمؤتمر COLM إلى أن خيوط المعالجة المستمرة للنماذج قللت من احتياجات السياق وتفوقت على نموذج GPT-5 Pro بدون أدوات في اختبار تقييم الألغاز.
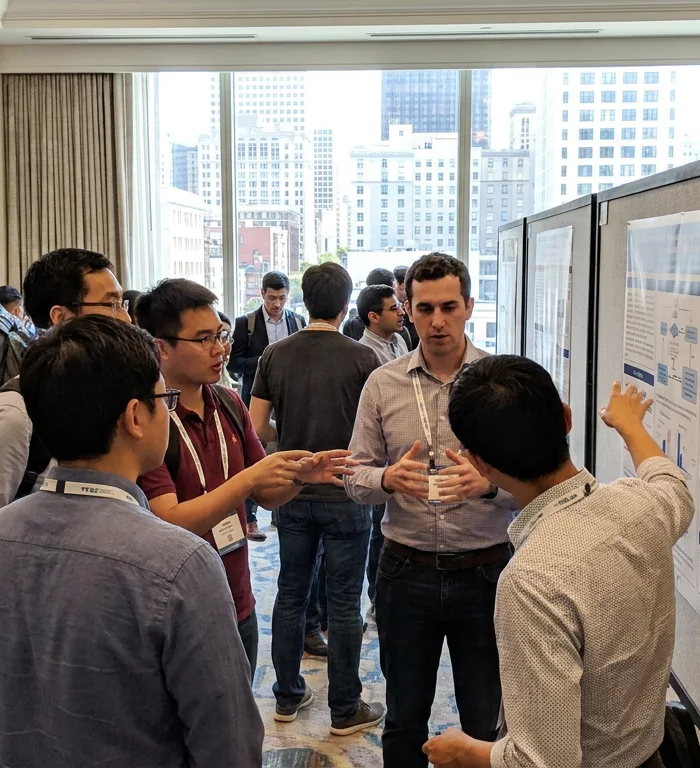
أظهر ملصق بحثي لنموذج لغوي يستند إلى نقل الرسائل قدمه باحثون في جامعة كارنيغي ميلون خلال مؤتمر COLM 2026 أن نموذج Qwen3-0.6B المضمون تحسينه نجح في حل 72% من ألغاز السودوكو بمقاس 25×25، وفقاً لمنشور على منصة X كتبه جونفان تشو في 12 أكتوبر.
وتكمن أهمية هذه النتيجة في أن تشو أشار إلى أن نموذج GPT-5 Pro بدون استخدام أدوات حل 20% فقط في اختبار التقييم نفسه، مما يجعل الملصق البحثي مثالاً بارزاً على تفوق التصميم المعماري على حجم النموذج في مهام الاستدلال المقيدة.
وصف منشور تشو عمل جامعة كارنيغي ميلون بأنه المحور الرئيسي من بين 10 ملصقات بحثية في مؤتمر COLM ركزت على أساليب التنسيق والتكيف والتقييم. وعُقد المؤتمر في الفترة من 6 إلى 9 أكتوبر في فندق هيلتون يونيون سكوير بمدينة سان فرانسيسكو، وفقاً للمنشور.
وتعتمد الآلية على نقل الرسائل: حيث تتولى خيوط معالجة منفصلة ومستمرة للنموذج اللغوي التعامل مع المشكلات الفرعية وتبادل النصوص فقط مع خيوط مجاورة محددة. ونقل تشو عن صفحة المشروع قولها: «البروتوكول مُكتسب وليس مبرمجاً بشكل ثابت».
وفي إعداد لعبة السودوكو، قال تشو إنه تم تخصيص عامل واحد لكل خلية، بإجمالي 625 عاملاً في شبكة بمقاس 25×25. وتواصل كل عامل مع 64 جارة في الصفوف والأعمدة والمربعات، مما يشير إلى نسبة N/k تبلغ نحو 9.8 في ملخص المنشور لحجة توسيع السياق التي قدمتها الورقة البحثية.
أما الادعاء الأوسع فيتعلق بالكفاءة؛ إذ كتب تشو أن أكبر سياق لِخيط معالجة واحد بالنسبة للنهج التسلسلي ونهج التفريع والانضمام (fork-join) توسع بأسس تراوحت بين 1.78 و1.85 تقريباً مقارنة بعدد الخلايا، بينما توسع نهج النموذج اللغوي القائم على نقل الرسائل بمعدل 1.09.
وسلط الملخص نفسه الضوء على ملصقات بحثية أخرى في مؤتمر COLM. حيث وُصف مشروع SuperCoder بأنه رفع نسبة نجاح نموذج Qwen2.5-Coder-7B من 61.4% وسرعة 1.10 ضعف مقارنة بمترجم gcc -O3 إلى نسبة نجاح 95.0% وسرعة 1.46 ضعف. وقال تشو إن نموذج Claude Opus 4، وهو أسرع نموذج دون تدريب مسبق (zero-shot) في تلك المقارنة، حقق نسبة 51.5% وسرعة 1.43 ضعف.
استهدفت عدة ملصقات بحثية خفض تكلفة الاستدلال أو تحسين التقييم بدلاً من زيادة حجم النماذج. حيث استخدم مشروع HyperThink شبكة فائقة (hypernetwork) لكتابة تحديث انحياز لكل سؤال ينطبق على نحو 0.015% من أوزان Qwen3-0.6B، بينما وُصف مشروع ORCA بأنه يوفّر 47.5% من خطوات الاستدلال ضمن التوزيع المستهدف.
لكن القيود تظل جوهرية. إذ إن رواية تشو تعتمد على منشور في منصة X يحدد ملخصات لملصقات وأوراق بحثية، ولا توفر المواد المقدمة الأوراق البحثية الأساسية بالكامل. كما تشير إلى محاذير تتعلق بنظرية جامعة كارنيغي ميلون، بما في ذلك ادعاءات الحد الأعلى، وشرط المعالجة المحلية المفترض، وتكلفة التوجيه الأولي التي لا تتضمنها الصيغة الرئيسية.
وقال تشو إن المقارنات بين النماذج الرائدة استخدمت 20 لغزاً لكل حجم عبر واجهة برمجة التطبيقات الدفعية (batch API)، و«لم تكن تهدف إلى تقديم تقييم مباشر متكافئ». وبالنسبة لمطوري الألعاب والوكلاء التفاعليين، يُفضل التعامل مع هذا العمل باعتباره مؤشراً بحثياً وليس دليلاً على منتج مُنشر وجاهز للاستخدام.
المصدر: منشور على منصة X بواسطة جونفان تشو، 12 أكتوبر 2026
More stories
- باينانس تغلق مجمع التعدين بينما تواصل أعمال التداول نشاطها
- تكنولوجيا الروبوتات في أمازون تختبر التوازن بين السرعة والسلامة
- ادعاء تصدر Gears E-Day المركز الثاني في عدد اللاعبين يثير الجدل
- تقنية نقل الرسائل ترفع نسبة نجاح النماذج الصغيرة في حل ألعاب السودوكو إلى 72%
- طريقة "DualQuant" قد تخفض استهلاك نماذج اللغات الكبيرة للذاكرة بمقدار 2.61 ضعفاً
- شركة Loops AI تجمع 3.5 مليون دولار في جولة تمويل أولي بمشاركة a16z Speedrun
- إلكترونيك آرتس تضيف فريق "إيه إف سي ريتشموند" للسيدات إلى لعبة "إي إيه سبورتس إف سي 27"
- SemiCat يحقق دقة 49.94% على اختبار TinyGSM في مسودة بحثية حول الذكاء الاصطناعي
آخر الأخبار
- «أكورد يون» تدمج 50 مهندساً عبر الاستحواذ على شركة «سترايد» للذكاء الاصطناعي
- سنترات تستهدف الاستحواذ على 70% من مشاريع أزيموت باتفاقية كسب حصة بقيمة 16 مليون دولار
- تقرير عن مسيّرات حزب الله يختبر استراتيجية واشنطن لوقف إطلاق النار في لبنان
- تكاليف الذاكرة تدفع شحنات الهواتف الذكية للتراجع بنسبة 20%
- تاي تشي قد يخفف الألم في اضطرابات العضلات والعظام بمراجعة شاملة
- أرباح "سيتي جروب" تتجاوز التوقعات مع تسجيل تداول السندات أعلى مستوى في عقد
- صادرات قونية تقترب من 4 مليارات دولار وسط تقييم القادة للمخاطر
- أرباح مصرف الشارقة الإسلامي ترتفع 9% مع نمو التمويلات