Yapay Zeka Şirketlerinin Avrupa Sahaflarındaki Veri Toplama Operasyonu ve Telif Tartışmaları
Yapay zeka şirketlerinin kitapları dijitalleştirip imha etmesi, telif hakları ve kültürel mirasın korunması konusunda ciddi riskler yaratıyor.
Ayla Demirhan ·
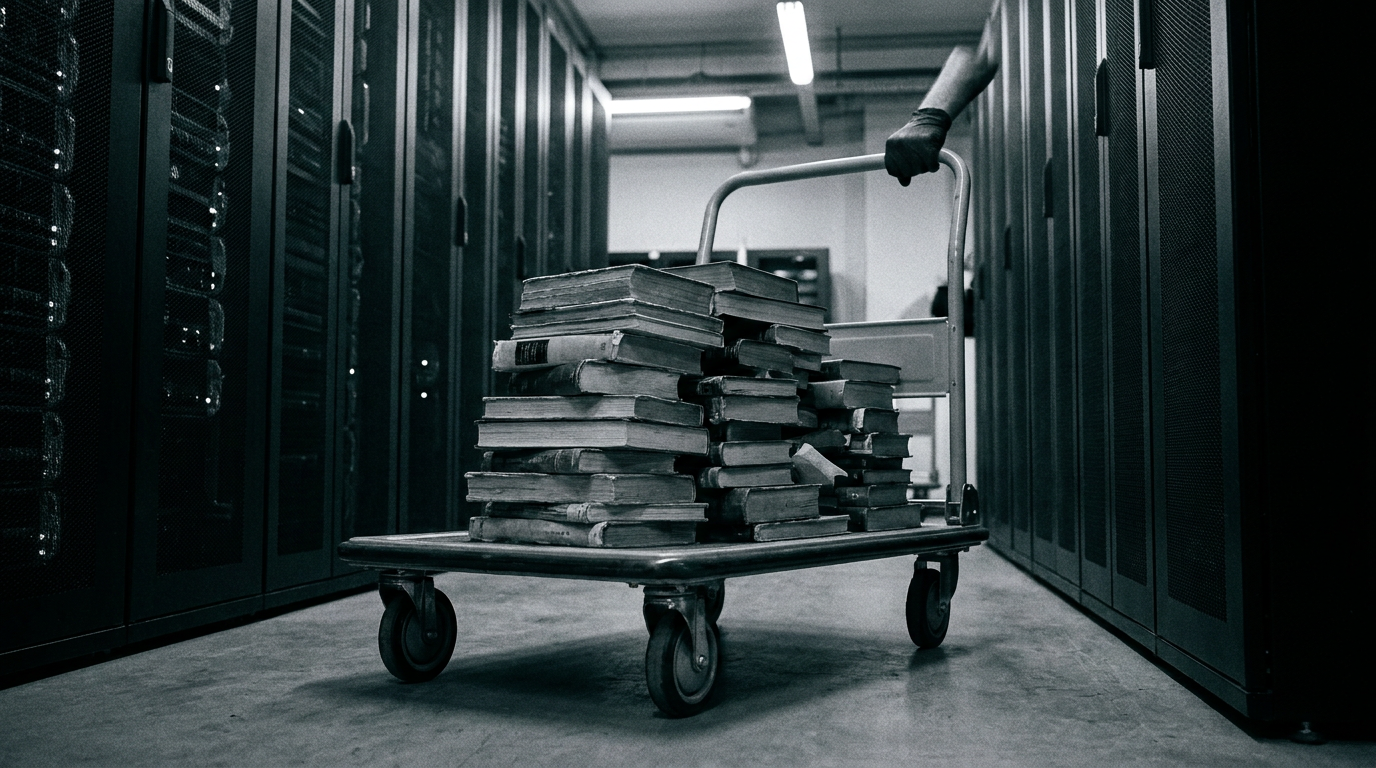
Yapay zeka modellerini eğitmek amacıyla yeni ve özgün veri kaynaklarına ihtiyaç duyan teknoloji şirketlerinin, Avrupa genelindeki sahaflardan kurgu dışı ikinci el kitapları toplu olarak satın aldığı bildiriliyor. İddialara göre, donanımlı cihazlarla taranarak dijital ortama aktarılan bu kitapların fiziksel nüshaları daha sonra teknoloji firmaları tarafından kitlesel ölçekte imha ediliyor.
Sektör analistleri, büyük dil modelleri geliştiren teknoloji firmalarının internet üzerinde serbestçe erişilebilen arşivlerin ve çevrimiçi veri setlerinin büyük bir bölümünü halihazırda sistemlerine entegre ettiğini belirtiyor. Açık kaynaklı verilerin tükenme noktasına gelmesi, şirketleri henüz dijital ortamda bulunmayan veya çevrimiçi sınırları dar olan basılı eserlere yönlendiriyor.
Yeni stratejinin, yapay zeka sistemlerinin uzmanlık gerektiren konulardaki analiz yeteneğini ve sektörel bilgi derinliğini artırma amacı taşıdığı ifade ediliyor.
Kitap toplama operasyonuna dair ilk işaretlerin
Kitap toplama operasyonuna dair ilk işaretlerin, mayıs ayında Almanya'daki sahaflara gece saatlerinde verilen otomatik siparişlerle ortaya çıktığı belirtiliyor. Kısa bir süre içinde Fransa, Avusturya ve diğer Avrupa ülkelerindeki ikinci el kitap satış ağlarında da birbirine benzer olağandışı alımların tespit edilmesi, sürecin organize bir veri toplama ağı olduğuna işaret ediyor.
Siparişlerin genel yapısı incelendiğinde, alıcıların koleksiyon değeri taşıyan nadir eserler yerine daha teknik ve spesifik kriterlere sahip kitaplara odaklandığı görülüyor.
Satın alımların merkezinde 1970 sonrasında yayımlanmış, uluslararası standart kitap numarasına (ISBN) sahip ve uzun süredir raflarda bekleyen kurgu dışı eserler yer alıyor. Hukuk, tarih, ekonomi, mühendislik, dil, gastronomi ve yerel kültür gibi alanlardaki kitapların tercih edildiği bu sipariş ağında, satıcılardan her eser için yalnızca tek bir nüsha talep ediliyor.
Kitapçılar, bu spesifik yöntemin eserleri ticari bir amaçla yeniden satmak için değil, salt metin verisine dönüştürülmek üzere kurgulandığı yönündeki iddiaları güçlendirdiğini belirtiyor.
Şirketlerin Uygulamaları ve Adil Kullanım Tartışması
Avrupa çapında genişleyen operasyonlarda adı geçen kurumlar, veri madenciliği iddialarına karşı farklı yasal duruşlar sergiliyor. Sürece dahil olduğu öne sürülen Kanada merkezli Zoom Books şirketi, yürüttüğü faaliyetlerin olağan ikinci el kitap ticareti standartları içerisinde kaldığını savunarak suçlamaları reddediyor.
Diğer taraftan, yapay zeka pazarının önde gelen firmalarından Anthropic'in benzer yöntemlerle eserleri modellerine veri sağlamak üzere işlediği ve bu tür uygulamaların Amerika Birleşik Devletleri'nde "adil kullanım" hakları çerçevesinde değerlendirildiğine dair emsal oluşturan yasal süreçlerin bulunduğu hatırlatılıyor.
Fiziksel Hafıza Kaybı ve Kültürel Miras Riskleri
Yapay zeka veri hattı
Yapay zeka veri hattı, telif haklarıyla ilgili hukuki cephenin ötesinde kültürel mirasın korunmasına yönelik ciddi sosyal riskler barındırıyor. Sahaflar, özellikle baskısı yıllar önce tükenmiş ve sadece ikinci el raflarında yaşam bulan eserlerin okurlarla yeniden buluşmasını sağlayan organik dolaşım ağının sistematik alımlarla kırıldığını ifade ediyor.
Taranan kitapların parçalanarak veya geri dönüşüme gönderilerek imha edilmesi, ileride yeniden basılma şansı bulunmayan alternatif bilgi kaynaklarının gelecekte kamuya tamamen kapanması tehlikesini beraberinde getiriyor.
Büyük dil modellerinin nitelikli metin verisine olan yapısal ihtiyacı büyümeye devam ederken, küresel yayıncılık ekosistemi ile teknoloji sektörü arasındaki hukuki mücadelelerin ivme kazanması bekleniyor. Regülatörlerin, fikri mülkiyet yasalarındaki istisnaları fiziksel eserlerin büyük veri setlerine dahil edilmesini kapsayacak şekilde yorumlayıp yorumlamayacağı, teknoloji şirketlerinin gelecekte yeni veri kaynaklarına nasıl erişeceğini belirleyecek.