KVKK, 80ler challenge için veri risklerini tek tek sıraladı
Kabarık saçlar, vatkalı ceketler ve film grenleriyle sosyal medyayı saran ChatGPT 80’ler akımı eğlenceli görünüyor. Ancak KVKK, yapay zeka uygulamalarına yüklenen fotoğrafların biyometrik verilerin işlenmesine yol açabileceği uyarısında bulunuyor
Atlas Newsdesk ·
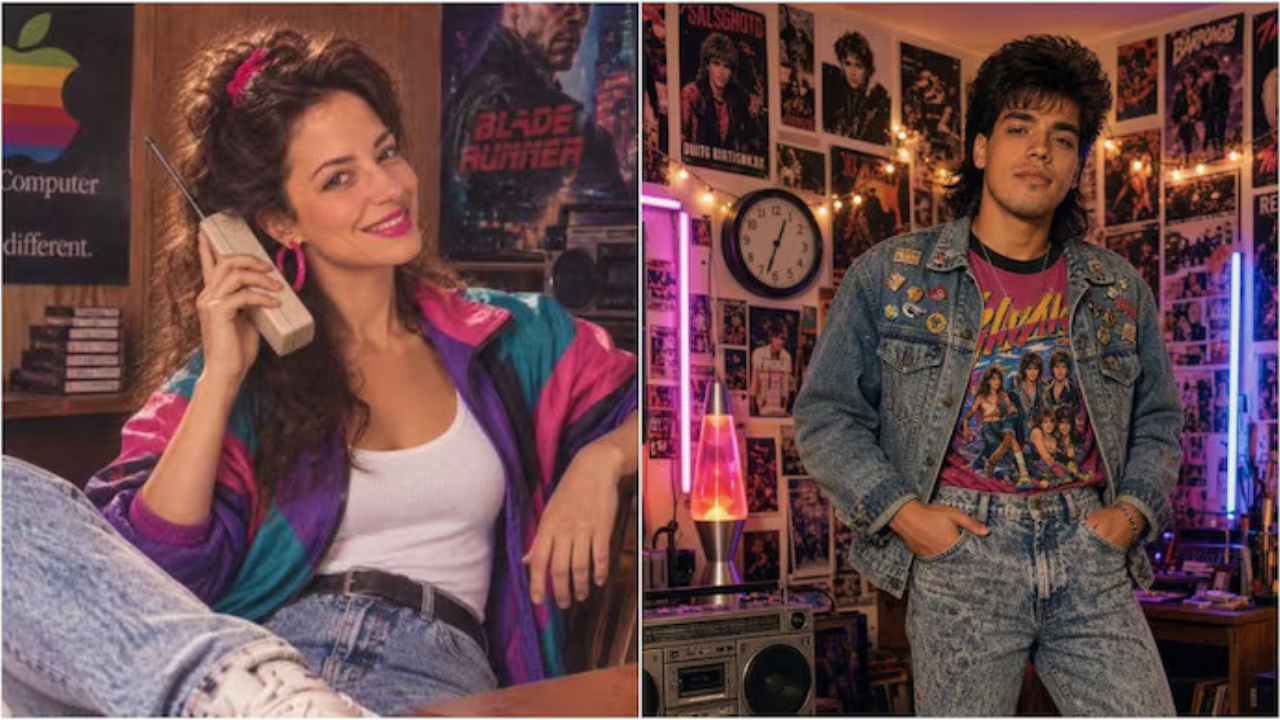
80ler challenge akımı, fotoğrafları nostaljik portrelere çevirirken KVKK kullanıcıları biyometrik veri riski konusunda uyardı.
Sosyal medyada yayılan akım, kullanıcıların bugünkü yüz görüntülerini yapay zeka araçlarıyla 1980’leri çağrıştıran portrelere dönüştürüyor. Kabarık saç, vatkalı ceket ve stüdyo ışığı efekti kısa süreli eğlence sağlasa da yüklenen dosya yalnızca görsel bir tercih değil, kişisel veri aktarımı anlamına da gelebiliyor.
KVKK’nın uyarısı fotoğrafa odaklandı
Kişisel Verileri Koruma Kurumu, akımın yayılması üzerine fotoğraf paylaşan kullanıcıları dijital mahremiyet konusunda dikkatli olmaya çağırdı. Kurum, bu tür araçların yüz görüntülerinden biyometrik verilerin işlenmesine yol açabileceğini belirtti.
KVKK’ya göre kullanıcılar, bir görüntüyü yüklemeden önce uygulamanın hangi veri alanlarına eriştiğini ve bunları hangi amaçlarla değerlendirebileceğini incelemeli. Kurum mesajını, "Hatıralar yaşasın, size ait olan sizde kalsın" sözleriyle tamamladı.
Bir fotoğraf dosyası, ekranda görünen yüzden daha fazla bilgi taşıyabilir. Çekim zamanı, cihaz bilgisi ve bazı dosyalarda konum kaydı gibi meta veriler, kullanıcı fark etmeden görselle birlikte platforma aktarılabilir.
Kadrajdaki ayrıntılar da ayrı bir risk oluşturur. Ev kapısı numarası, sokak tabelası, araç plakası, iş yeri logosu ya da arka plandaki başka kişiler, nostaljik filtre uygulanırken üçüncü taraf bir hizmetin sistemine girebilir.
ChatGPT ayarlarında iki yol
ChatGPT’ye yüklenen görsel, ilgili konuşmanın parçası haline gelir. OpenAI’ın açıklamasına göre bireysel hesap sahipleri, yeni konuşmaların model geliştirme amacıyla kullanılmasını istemiyorsa ayarlardaki veri kontrollerinden "Modeli herkes için iyileştir" seçeneğini kapatabilir.
Bu tercih kapatıldığında sohbetler hesap geçmişinde görünmeyi sürdürebilir, ancak OpenAI’a göre model eğitiminde kullanılmaz. Kullanıcı için fark, görselin tamamen yok olması değil; dosyanın platform içindeki kullanım amacının sınırlandırılmasıdır.
Diğer seçenek Geçici Sohbet kullanmaktır. OpenAI, bu moddaki konuşmaların geçmişte görünmediğini, hafıza oluşturmadığını ve modellerin geliştirilmesinde kullanılmadığını; güvenlik gerekçesiyle tutulan kopyaların ise en fazla 30 gün sonra silindiğini bildiriyor.
Bu açıklamalar, her fotoğrafın otomatik olarak yapay zeka eğitim verisine dönüştüğü anlamına gelmez. Veri kullanımı, seçilen ürünün çalışma biçimine, hesabın gizlilik tercihine ve hizmetin saklama politikalarına göre değişir.
Paylaşmadan önce silinecek izler
Kullanıcıların ilk kontrolü, fotoğrafın arka planı olmalı. Plaka, okul adı, iş yeri tabelası, bina girişi veya başka kişilerin yüzleri kadrajdaysa görüntü kırpılmalı ya da bulanıklaştırılmalı.
İkinci kontrol dosyanın kendisidir. Konum bilgisi ve çekim ayrıntıları gibi meta veriler kaldırılmalı; kimlik belgesi, sağlık kaydı, çocuk fotoğrafı ve mahrem içerik taşıyan görseller yapay zeka araçlarına yüklenmemelidir.
Eğer kullanıcılar gizlilik ayarlarını kontrol edip geçici sohbet veya eğitim dışı bırakma seçeneklerini kullanırsa, ChatGPT ve benzeri hizmetlerde veri kullanım alanı daralır. Bu yol, yapay zeka şirketleri için güveni koruyan bir mekanizma olurken sektörde daha açık saklama ve silme politikalarına baskı yaratabilir.
Eğer kullanıcılar ayarları incelemeden akıma katılırsa, risk tek bir portreyle sınırlı kalmayabilir. Küresel ölçekte yapay zeka hizmetleri için veri yönetişimi ve uyum maliyetleri daha görünür hale gelir; OpenAI gibi platformlar ise tüketici güveni ile model geliştirme ihtiyacı arasındaki dengeyi daha açık anlatmak zorunda kalır.