
"كامبو بينش" يختبر نماذج اللغات الكبيرة عبر 74 حالة في الطب الياباني
أظهر الإطار التقييمي المراجع من قبل الأطباء أن أفضل نماذج الذكاء الاصطناعي ما تزال تتخلف عن الإجابات المرجعية في استشارات طب الكامبو الخاصة بالمرضى.
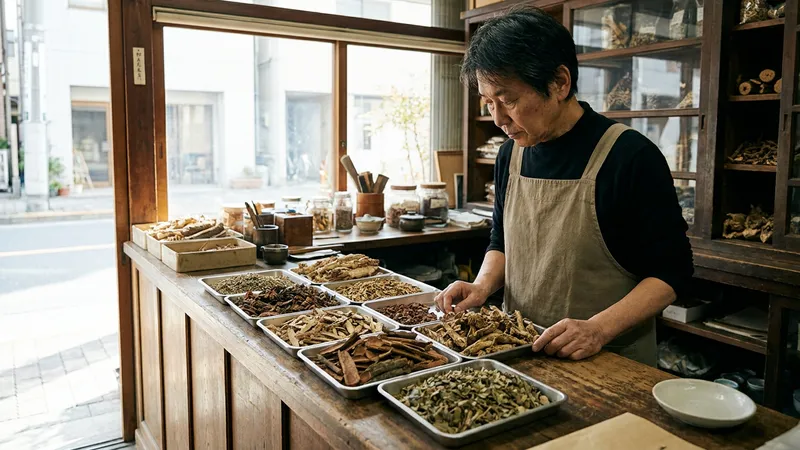
قدّم هيدياكي تاكاتا وخمسة مؤلفين مشاركين نموذج "كامبو بينش" (KampoBench)، وهو معيار تقييم يضم 74 سيناريو تمت مراجعتها من قبل أطباء لنماذج اللغات الكبيرة -وهي أنظمة ذكاء اصطناعي تولد النصوص- في مجال طب الكامبو الياباني، وذلك في دراسة أولية نُشرت على موقع "ميدأركايف" (medRxiv) في 11 أكتوبر.
وتكتسب هذه الدراسة الأولية المؤرخة في 11 أكتوبر أهمية بالغة لتقييم الذكاء الاصطناعي السريري لأن أفضل نموذج حقق نتائج تتراوح بين 74.8% و86.3% عبر مختلف المقيمين، وهو ما يقل عن الإجابات المرجعية المراجعة من قبل الأطباء والتي تراوحت بين 87.9% و92.4%.
آلية العمل
يختبر معيار "كامبو بينش" قدرة النموذج على التعامل مع التقييم القائم على نمط الاستشارات الطبية، بدلاً من مجرد الإجابة عن أسئلة الامتحانات. وقال المؤلفون إن التقييمات السابقة ركزت على دقة الامتحانات، بينما لم يقس أي معيار سابق ما إذا كان بإمكان النماذج تطبيق معرفة طب الكامبو على استشارات خاصة بكل مريض على حدة.
ويتضمن المعيار 310 معايير مرتبطة بالمحادثات الفردية، وفقاً للدراسة الأولية. وقد صُممت السيناريوهات ومعايير التقييم والإجابات المرجعية أولاً باستخدام نموذج لغوي كبير، ثم جرت مراجعتها من قبل أطباء معتمدين في طب الكامبو.
ووصف تاكاتا والمؤلفون المشاركون المعيار المستهدف بهذه الطريقة: "يجب أن يقيس التقييم في الطب التقليدي الأحكام التي تطلبها الاستشارة الطبية، وليس الاسترجاع المباشر للمعلومات فحسب".
وقيّم المؤلفون 10 نماذج حالية من ثلاثة مزودين. ونظراً لأن النماذج اللغوية الكبيرة المُقيمة قد تفضل الأنظمة المنتمية إلى عائلة النماذج الخاصة بها، فقد تم تقييم كل استجابة بواسطة نموذج تقييم واحد من كل مزود، وفقاً للدراسة الأولية.
وقال المؤلفون إن المعيار يتبع تصميم "هيلث بينش" (HealthBench). ولا يذكر النص المقدم أسماء النماذج العشرة أو المزودين الثلاثة.
فجوات الأداء
وكانت النتيجة الرئيسية تتمثل في وجود فجوة بين معرفة مفاهيم طب الكامبو واستخدامها في حالة مرضية. وكتب المؤلفون أن القشور كان في تطبيق المعرفة على الاستشارة الطبية، وليس في امتلاك المعلومات الأساسية ذاتها.
وحققت النماذج أفضل أداء في المعايير المتعلقة بالنصيحة لطلب الرعاية الصحية، حيث بلغت الموثوقية 83.6%، وفقاً للدراسة الأولية. في حين سجلت أسوأ أداء عندما كان على الإجابات ربط مخاطر معروفة لعقار خام بحالة المريض المحددة، بموثوقية بلغت 17.5%.
ولم يكن ذلك الضعف مجرد إخفاق في ذكر المكون ذي الصلة؛ حيث قال المؤلفون إن 79.2% من الاستجابات في تلك الفئة ذكرت العقار باسمه، مما يشير إلى أن المهمة الأكثر صعوبة كانت ربط خطر معروف بالحقائق الخاصة بالاستشارة الطبية.
وكانت الترتيبات متسقة عبر نماذج التقييم المختلفة. وأفادت الدراسة الأولية بأن معامل ارتباط الرتب لسبيرمان (Spearman's rho)، وهو إحصاء يقيس ارتباط الترتيب، تراوح بين 0.952 و0.976 عبر المقيمين.
كما قاس المؤلفون ما إذا كان نموذج التقييم ينحاز للأنظمة المنتمية لعائلته. وأفادوا بوجود انحراف لصالح عائلة النموذج يتراوح بين 0.4 و0.6 نقطة مئوية، وقالوا إنه أقل من الانحراف المعياري لأسلوب "البوتستراب" لقياس واحد، وهو مقياس لتقلب المعاينة.
ومع ذلك، تفاوت تساهل المقيمين بمقدار 14.3 نقطة، وفقاً للدراسة الأولية. وأدت هذه النتيجة بالمؤلفين إلى القول إن درجة "كامبو بينش" لا تكون صالحة للاستخدام إلا عندما يُكشف عنها جنباً إلى جنب مع المقيم الذي أصدرها.
القيود والوصول
تُعد هذه الدراسة مسودة أولية نُشرت على موقع "ميدأركايف" ولم تخضع للمراجعة والتدقيق من قبل الأقران. ويذكر موقع "ميدأركايف" أن الدراسات الأولية تعرض أبحاثاً طبية لم تُقيم بعد ويجب عدم استخدامها لتوجيه الممارسة السريرية.
وكشف المؤلفون عن وجود تضارب في المصالح؛ حيث حصل تاتسويا نوغامي على رسوم محاضرات وتمويل أبحاث مشتركة من شركة "تسومورا وشركاه" (Tsumura & Co.)، ورسوم محاضرات من شركة "كراسي للصيدلانيات" (Kracie Pharmaceuticals) خلال الأشهر الـ 36 الماضية.
كما حصل هيروكي إينوي وكازوشي أونيدا على رسوم محاضرات من شركة "تسومورا وشركاه" خلال الفترة نفسها البالغة 36 شهراً، وفقاً للدراسة الأولية. ويعمل تيتسوهيرو يوشينو في جامعة كيو لإجراء أبحاث مشتركة مع شركة "تسومورا وشركاه"، بينما أعلن هيدياكي تاكاتا ويوشيناو هارادا عدم وجود تضارب في المصالح.
وتمنح مجموعة البيانات المودعة في مستودع "زينودو" (Zenodo) ترخيص CC BY 4.0، إلا أن السيناريوهات الـ 74 والمعايير الـ 310 مقيدة حتى نشر المقال في مجلة علمية. وقال المؤلفون إن السجل نفسه يحتوي على نتائج التقييم لكل معيار لجميع النماذج العشرة والإجابات المرجعية تحت المقيمين الثلاثة.
وقال المؤلفون إن استجابات النماذج وتفسيرات المقيمين لم تُودع، لتخفيض فرصة تحول معيار التقييم إلى جزء من بيانات التدريب المستقبلية. وذكروا أن تلك المواد متاحة من المؤلف المسؤول عند الطلب، بينما تتاح شفرة التقييم وشروط القياس ومصدر مجموعة البيانات على منصة "جيت هاب" (GitHub).
المصدر: دراسة أكاديمية أولية، ميدأركايف، 11 أكتوبر 2026
More stories
- أسهم "بلاك روك" تتراجع بأكثر من 8% عن أعلى مستوياتها لعام 2026 قبل صدور نتائج الأعمال
- "كامبو بينش" يختبر نماذج اللغات الكبيرة عبر 74 حالة في الطب الياباني
- زيلينسكي يطلب وقفاً لإطلاق النار لمدة 60 يوماً بعد تصريحات ترامب
- مسح MICS7 في بنغلاديش يكشف عن مستويات رصاص مرتفعة لدى 38.5% من الأطفال
- «تيكيتوري» تعلن تجاوز إجمالي قيمة حجوزاتها 550 ألف يورو في ستة أشهر
- ميرك كيه جي آيه آيه تتفوق على ميديسينوفا في 8 من أصل 15 معياراً مالياً
- أرباح "أنالي" ترتفع بنسبة 28% بعد توسيع محفظة الأوراق المالية المدعومة بالرهن العقاري
- مصفاة غوجارات التابعة لشركة النفط الهندية ستعمل بطاقة 18 مليون طن
آخر الأخبار
- تحويل مسار رحلات طيران سعودية بعد استهداف مطار الدمام
- تقارير تفيد بتهديد الولايات المتحدة بوقف إمدادات الأسلحة وتبادل المعلومات الاستخباراتية مع أوكرانيا
- مطار الرياض يتعرض لضربة جديدة وسط دراسة ترامب لدور أمريكي
- مطورو "إكس آر بي ليدجر" يطلقون تحديثاً طارئاً لإصلاح خلل في صك العملات يعود إلى تسع سنوات
- الحوثيون يستهدفون مطار الرياض بعد مقتل 12 شخصاً
- مجلس الوزراء اليمني يقر مشروع قانون لتصنيف الحوثيين تنظيمًا إرهابيًا بعد مقتل 12 شخصًا
- بانداي نامكو تحدد عام 2027 لاختبار اللعب المشترك للعبة سباركينغ زيرو